「AI 검색 최적화」를 찾아보면 해야 할 것이 끝없이 나옵니다. AI용 파일, 특수 태그, 새로운 마크업. 사장님 입장에서는 무엇부터 해야 할지 막막해집니다.
구글은 이렇게 말합니다
구글 검색 센터는 AI 개요나 AI 모드에 나오기 위한 추가 조건이나 특별한 최적화는 없다고 안내합니다. 구글 검색에 색인되고 스니펫(설명 글)과 함께 나올 수 있는 페이지여야 하며, 그렇다고 노출이 보장되지는 않는다고도 적었습니다. AI 전용 텍스트 파일이나 특별한 구조화 데이터도 필요 없다고 합니다.
OpenAI와 Anthropic은 각자의 검색용 로봇을 막으면 검색 답에 반영되지 않을 수 있다고 안내합니다. 결국 기본은 「읽을 수 있게 열어 두기」와 「읽을 만한 글 두기」입니다.
흔히 듣는 처방을 공식 문서·연구와 나란히 놓으면 아래와 같습니다.
표 1 · 흔히 듣는 처방과 공식 안내·연구
| 흔히 듣는 말 | 공식 안내·연구에 적힌 것 | 출처 |
|---|---|---|
| AI용 파일(llms.txt)을 꼭 만들어야 한다 | 구글은 AI 기능에 나오려고 새 기계 판독용 파일·AI 텍스트 파일·마크업을 만들 필요가 없다고 안내. llms.txt는 2024년 9월에 나온 제안 형식 | 구글 AI 기능 · llmstxt.org |
| AI용 특수 schema 표시를 달아야 한다 | 따로 추가해야 할 특별한 schema.org 구조화 데이터는 없음 | 구글 AI 기능 |
| 구조화 데이터는 많이 달수록 좋다 | 화면에서 읽는 사람에게 보이지 않는 내용은 표시하지 말 것 | 구조화 데이터 일반 지침 |
| 키워드를 많이 반복하라 | 키워드 반복(keyword stuffing)은 스팸 정책 위반 사례. GEO 연구에서도 효과가 약했음 | 스팸 정책 · GEO 논문 |
| 숨은 글로 AI에게만 보여 주자 | 흰 바탕 흰 글씨처럼 사람에게 안 보이게 넣은 글은 스팸 정책 위반 사례 | 스팸 정책 |
| 로봇 설정은 신경 안 써도 된다 | 검색용 로봇(OAI-SearchBot·Claude-SearchBot)을 막으면 검색 답에서 빠지거나 보일 가능성이 줄어듦 | OpenAI · Anthropic |
연구 쪽 근거도 있습니다. 생성형 검색 엔진 최적화(GEO, Generative Engine Optimization)라는 말을 처음 정리한 Aggarwal 등 연구진의 논문(KDD 2024)은 같은 글을 여러 방식으로 고쳐 생성형 답에 얼마나 실리는지 쟀습니다. 출처 인용 넣기, 믿을 만한 인용문 넣기, 통계 수치 넣기가 가장 효과가 컸고, 기준보다 답 속 노출량(답에서 차지한 위치를 반영한 단어 수)이 41%, 주관적 인상 점수가 28% 올랐습니다. 반대로 검색어를 더 끼워 넣는 키워드 반복은 효과가 약했습니다. 연구진은 효과가 분야마다 다르다고도 적었습니다. 실험실 시험지에서 나온 결과라 실제 엔진에서 같은 폭으로 오른다는 뜻은 아닙니다.
저희가 권하는 점검 순서
공식 안내의 접근 요건(로봇을 막지 않기)을 참고해 저희가 정한 점검 순서입니다. 질문 정하기·답 글 쓰기·다시 재기는 저희 제안입니다. 어느 단계가 얼마나 효과가 있는지는 사이트마다 달라서, 마지막의 다시 재기가 꼭 필요합니다.
- 로봇 확인 : 사이트 주소 뒤에 /robots.txt를 붙여 엽니다(예 : 우리가게.kr/robots.txt). 「User-agent: *」나 검색용 로봇 이름(Googlebot·OAI-SearchBot·Claude-SearchBot) 아래에 「Disallow: /」처럼 공개할 페이지를 막는 줄이 없는지 봅니다.
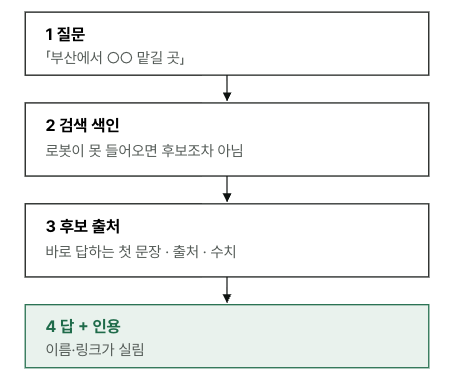
- 질문 정하고 먼저 재기 : 손님이 할 법한 질문을 손님 말투로 정합니다. 「부산 초등학교 방과후 로봇코딩 출강 업체를 찾고 있어」 같은 문장입니다. 고치기 전에 이 질문을 한 번 물어 지금 결과를 적어 둡니다. 그래야 나중에 비교할 수 있습니다.
- 답 글 쓰기 : 질문을 그대로 제목으로 두고, 첫 문단에서 바로 답합니다. 설명은 그 아래에 붙입니다.
- 사실 맞추기 : 주소, 시간, 대상처럼 자주 묻는 사실을 모든 페이지에서 같은 표현으로 맞춥니다.
- 다시 재기 : 고친 뒤 2번과 같은 질문·같은 방식으로 다시 물어, 처음 기록과 비교합니다.
10월 12~17일 질문 56개로 잰 결과, 저희 교육 회사는 제미나이 56개 중 35개(63%), GPT 24개(43%), 클로드 1개(2%)에서 나왔습니다. 어느 고침이 얼마나 효과였는지 하나하나 나눠 말하기는 어렵습니다. 다만 같은 기본기로도 엔진마다 결과가 크게 다르다는 걸 보여 주는 숫자라 숨기지 않고 적습니다.
구조화 데이터는 어떻게 할까
가게 정보처럼 검색엔진이 지원하는 구조화 데이터(검색엔진이 읽기 쉬운 표시)는 검색엔진이 내용을 이해하는 데 도움이 될 수 있습니다. 구글이 강조하는 건 하나입니다. 표시한 내용이 화면에 보이는 글과 같아야 한다는 점입니다. 화면에는 없는 내용을 표시에만 넣으면 오히려 문제가 됩니다. 새 표시를 다는 것보다, 이미 단 표시가 화면 글과 맞는지 먼저 확인해 보세요.
사이트가 없으면 어떻게 하나
작은 가게는 사이트 없이 블로그나 플레이스만 운영하는 경우가 많습니다. 그래도 시작할 수 있습니다. 검색에 잡히는 블로그나 홈페이지 한 장이라도, 손님 질문에 답하는 글을 두는 것부터입니다. 저희가 보는 기준은 「AI가 읽을 수 있는 곳에 우리가 직접 쓴 정확한 답이 있느냐」입니다. 처음부터 큰 사이트를 만들 필요는 없습니다.
피해야 할 것
- 검색엔진을 속이려는 숨은 글, 같은 말 반복
- 효과를 확인하지 않은 채 유행하는 설정을 전부 따라 하기
- 한 번 고치고 다시 재지 않기
특별한 설정보다 중요한 건 「손님 질문 → 답 글 → 다시 재기」를 반복하는 일입니다. 우리 사이트가 어디서 막혀 있는지 같이 보고 싶으시면 아래에서 측정 상담을 신청해 주세요.
자주 묻는 질문
- llms.txt 같은 AI용 파일을 꼭 만들어야 하나요?
- 구글은 AI 개요·AI 모드에 나오기 위해 AI 전용 파일이나 특별한 마크업이 필요 없다고 안내합니다. 저희는 그보다 손님 질문에 답하는 글을 먼저 권합니다.
- 그럼 가장 먼저 무엇을 고쳐야 하나요?
- 저희는 로봇이 사이트를 읽을 수 있는지, 손님이 묻는 질문에 바로 답하는 글이 있는지 두 가지부터 봅니다. 로봇 접근은 공식 안내에 나온 요건이고, 답 글은 저희가 정한 순서입니다.
측정 방법 : 숫자는 저희가 직접 잰 기록입니다. 클로드는 Claude Code(웹검색 사용), 제미나이는 Gemini 2.5 Flash API(구글 검색 근거 사용), GPT는 Codex CLI(웹검색 사용)로 같은 질문을 묻고, 답에 이름이 나오거나 인용 링크에 우리 주소가 있으면 「나옴」으로 셉니다. 휴대폰 앱에서 직접 물은 결과와는 다를 수 있습니다.
참고 : Google 검색 센터 — AI 기능과 웹사이트(2025-12-10 갱신) · Google 검색 센터 — 구조화 데이터 일반 지침(2026-07-10 갱신) · Google 검색 스팸 정책(2026-08-28 갱신) · Aggarwal 외, GEO: Generative Engine Optimization(KDD 2024, arXiv 2311.09735) · llms.txt 제안(Jeremy Howard, 2024-09-03) · OpenAI 크롤러 안내 · Anthropic — 웹 수집 로봇과 차단 방법
송병근 · (주)크리플레이 대표. 부산AI코딩스쿨을 운영하며, 회사 홈페이지가 AI 검색에 나오는지 매주 같은 질문으로 재고 고치고 있습니다.